Del master de una banda al salón de casa: el procesado de diálogo que apunta al audio profesional
Separación de voz y fondo, compresión asimétrica y ducking por sidechain. El Algoritmo Zainder visto desde el estudio, con la mirada en un futuro plugin.
Cualquiera que haya mezclado una maqueta en un home studio sabe que la voz y el resto de la banda no se pelean solo por volumen: se pelean por espacio. Cuando la voz no se entiende, subir el fader no suele ser la respuesta. Lo que se busca es hueco, ecualización quirúrgica y una compresión que no aplaste lo demás. El problema del cine doméstico es el mismo, solo que a otra escala y con un director de sonido que no va a venir a tu casa a ajustarlo.
Sobre esa idea trabaja el Algoritmo Zainder, un proyecto de Eduardo Garbayo documentado en Zenodo con un DOI público (https://doi.org/10.5281/zenodo.24437921). En esta casa nos interesa por la parte de oficio: es una cadena de procesado muy reconocible para quien haya trabajado en un bus de diálogo, solo que implementada en un grafo de FFmpeg.
El punto de partida: por qué se pierde la voz
En un sistema envolvente el diálogo va por el canal central. Al bajar la mezcla a estéreo, ese canal se suma con la música y los efectos, y la relación voz-fondo se desmorona. Si a eso le añades altavoces domésticos con respuestas irregulares entre 1 y 4 kHz —justo la zona donde las consonantes se distinguen—, el resultado es el clásico "¿qué ha dicho?".
La literatura de inteligibilidad insiste en lo que cualquier ingeniero de diálogo en postproducción ya intuye: la relación señal-ruido se juega por bandas. Trabajar la zona media-alta de la voz rinde mucho más que subir el volumen global.
La arquitectura: separar antes de tratar
En vez de meter un compresor en la mezcla completa —lo que provoca bombeo, ese vaivén de la música al ritmo de la voz—, la cadena separa primero en dos carriles. Después trata cada uno con sus parámetros y los vuelve a unir. Todo dentro de un único grafo de FFmpeg por archivo, con salida estéreo.
La cadena, como si fuera un preset
- Separación de voz y fondo.
- Paso alto a 120 Hz en ambos carriles.
- Compresión asimétrica: voz a 2,3:1 con ataque rápido, fondo a 1,7:1 con tiempos más lentos.
- Ecualización de inteligibilidad solo en la voz: −3 dB a 350 Hz, +4 dB a 2,5 kHz, +2 dB a 4,5 kHz.
- De-esser estático a 7 kHz y exciter opcional.
- Rebalanceo y ducking por sidechain.
- Loudnorm para normalizar sonoridad.
- Alimiter para controlar picos.
Un solo mando de intensidad, de 0 a 1, reparte el trabajo entre rebalanceo y compresión. Desde el punto de vista del diseño de plugins, esa simplicidad de control con tantos procesos por debajo es exactamente lo que se busca en un procesador comercial.
El sidechain: el truco que ya conoce cualquier mezclador
Una copia de la voz, amplificada y filtrada en banda, controla un compresor de cadena lateral sobre el fondo. Es la misma lógica del sidechain de bombo y bajo que usamos en rock, pero al revés: aquí la señal que manda es la voz y lo que cede es la banda sonora. Con una señal de control a −20 dBFS y un ratio de 3,95, la reducción teórica ronda los 12 dB.
Para quien tenga experiencia con FFmpeg, hay un detalle práctico: alimiter con el nivelado automático reescala la salida después de limitar y te devuelve el pico a 0 dBFS. Con level a 0 se respeta el techo. En una prueba con +3,5 dBFS de entrada, la salida quedó en −1,01 dBFS.
Niveles altos, pero con criterio
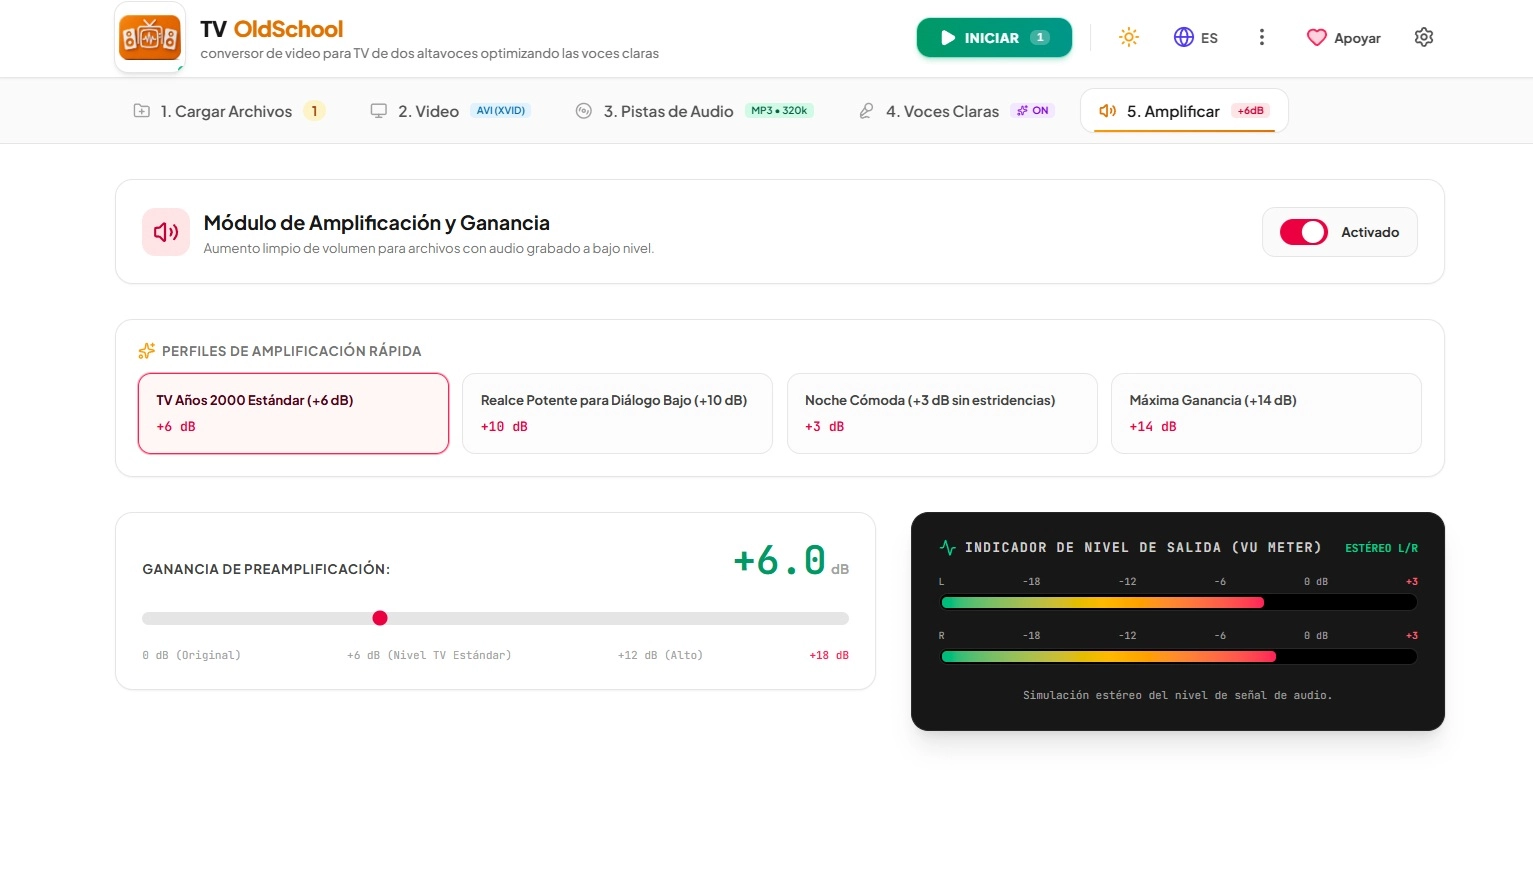
Por defecto la salida ronda los −10 LUFS, por encima de los −23 LUFS de la EBU R128. Es un ajuste pensado para escucha doméstica con altavoces modestos, y la función Amplificación permite volver a −16 LUFS. Para un máster de música sería demasiado alto; para una película en el salón, tiene sentido.
Lo que un plugin tendría que resolver
El propio autor deja claro que, por ahora, la implementación es en diferido, sobre archivos, y que no procesa señal en tiempo real. Tampoco hay validación con material real ni con oyentes: los números son analíticos. El paso a un plugin —inserto de diálogo en un DAW o efecto de bus en un editor de vídeo— exigiría resolver latencia, automatización del mando de intensidad y separación de fuentes en tiempo real. No es imposible, pero es otro nivel de ingeniería.
La aplicación actual se llama TV Old School y el código está abierto en SourceForge y en GitHub.
Para la gente de sonido
Lo que más valoramos aquí es la transparencia. La cadena está documentada con ecuaciones, parámetros y valores por defecto, y con una lista de 17 diferencias entre lo previsto y lo implementado. En un sector donde abundan los procesadores mágicos sin especificaciones, eso es de agradecer.
El artículo completo, con la formulación matemática y el plan de evaluación, está en https://doi.org/10.5281/zenodo.24437921.